Mục lục
Video chữ chui sau lưng nhìn khó, làm thì chỉ 4 bước
Kiểu video chữ to bay ra sau lưng người nói, quấn quanh đầu, đang xuất hiện dày trên Reels và TikTok. Nhìn qua tưởng phải quay studio rồi ngồi After Effects cả buổi, nên nhiều bạn marketer lướt qua và nghĩ “cái này không phải việc của mình”.
Clip mình vừa đăng làm đúng kiểu đó mà không cầm máy quay: mặt là ảnh AI render thành video, chữ là Claude viết code. Bài này tách quy trình thành 4 bước, mỗi bước kèm prompt mẫu để bạn copy và đổi phần trong ngoặc vuông là chạy được.
Nguyên lý chỉ có một: video gồm 3 lớp chồng lên nhau. Nền ở dưới, chữ ở giữa, người ở trên. Chữ nằm giữa nên phần nào bị người che sẽ trông như chui ra sau lưng.
Bước 1: Tạo ảnh khung đầu bằng Nano Banana (chừa trống trên đầu)

Mỗi cảnh trong video bắt đầu từ một ảnh tĩnh. Bạn đưa 1 ảnh chân dung rõ mặt của mình làm reference để AI giữ đúng gương mặt, rồi tả bối cảnh, góc máy và trang phục. Cả video nên mặc cùng một bộ đồ, ghép các cảnh lại mới liền mạch.
Điểm quan trọng nhất ở bước này: chừa khoảng trống phía trên đầu. Đó là chỗ đặt chữ lớn sau lưng. Ảnh cắt sát đầu thì về sau chữ không có chỗ để “chui”.
Cấu trúc Prompt:
The woman in the reference image, same face, same hairstyle, wearing [trang phục, ví dụ: a beige corduroy-collar jacket over a white turtleneck]. Vertical 9:16, photorealistic, shot on 35mm, soft natural skin texture, cinematic muted grey color grade.
[Góc máy, ví dụ: Medium shot, standing in front of a seamless light grey studio backdrop, facing camera].
Head placed slightly low in the frame, large empty space above her head.
Clip mẫu của mình dùng 5 góc: đứng phông xám nghiêng 3/4, nghiêng hẳn sang phải (để chữ quấn quanh gáy), ngồi bàn làm việc toàn cảnh, ngồi gõ laptop chính diện, và đứng chính diện cười cho cảnh kết.
Mẹo: render mỗi cảnh 2 đến 3 ảnh rồi chọn ảnh giống mặt nhất. Ảnh lệch mặt ở bước này thì sang video sẽ lệch nhiều hơn.
Bước 2: Đưa ảnh qua Veo hoặc Kling cho chuyển động (nhớ khóa máy)
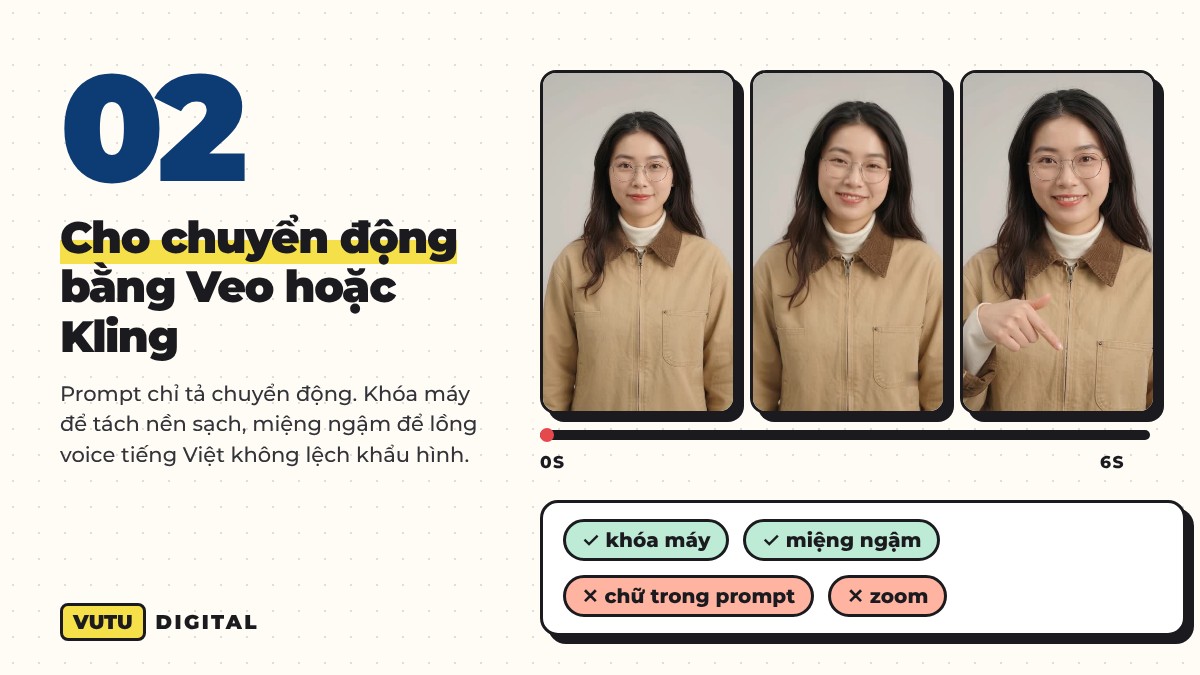
Ảnh khung đầu đưa vào image-to-video của Veo hoặc Kling, mỗi clip khoảng 5 đến 6 giây. Prompt video chỉ tả chuyển động, không tả lại ngoại hình vì ảnh đã lo phần đó.
Hai điều bắt buộc: khóa máy (camera đứng yên hoặc đẩy vào rất chậm) và miệng ngậm, không thoại. Camera rung thì bước tách nền sẽ nhòe viền. Còn nếu để AI tự nói, nó thường nói tiếng Anh, lúc lồng voice tiếng Việt vào khẩu hình sẽ lệch. Cảnh cuối trong clip của mình phải render lại đúng vì lỗi này.
Cấu trúc Prompt:
[Hành động, ví dụ: She smiles warmly at camera, nods twice, then points down toward the bottom of the screen with her right hand].
No dialogue, no speaking, lips stay closed.
Locked-off static camera, very slow push-in, background stays still. Silent.
Ô negative prompt: text, subtitles, logo, watermark, talking, lip movement, distorted hands, extra fingers, face morphing, camera shake.
Mẹo: không viết chữ vào prompt, kể cả tên kênh. Chữ AI vẽ ra hay sai chính tả tiếng Việt và sẽ dính chết vào hình, không xóa được.
Bước 3: Nhân đôi clip, lớp trên xóa nền
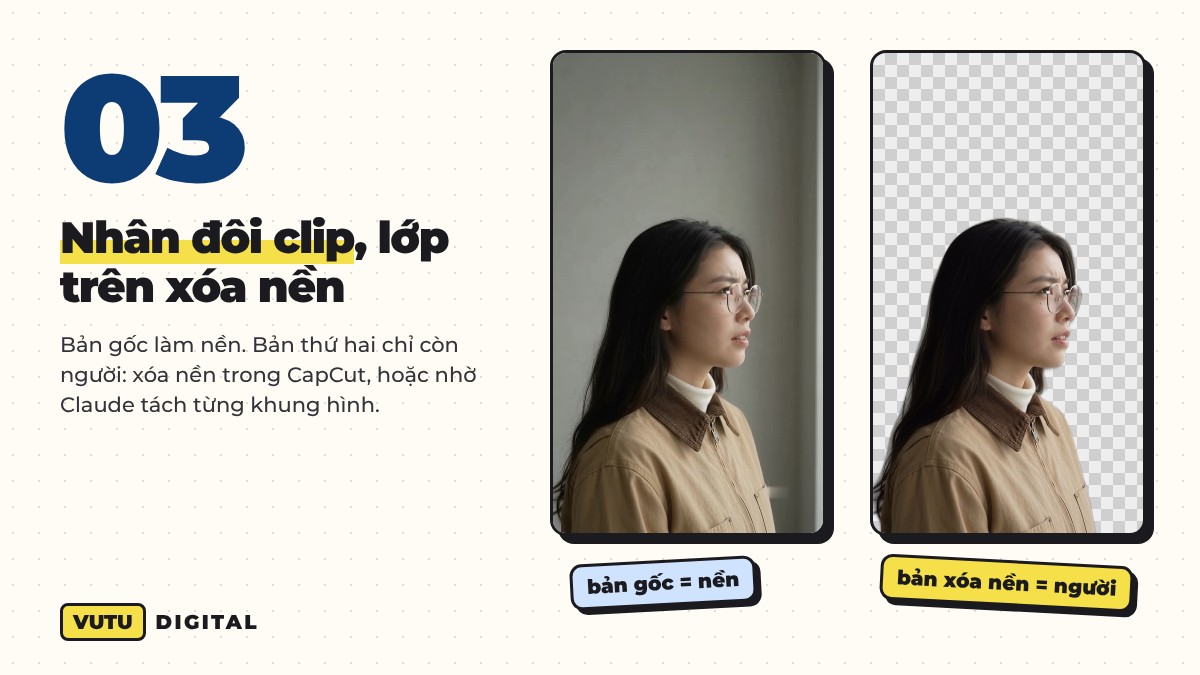
Đây là bước tạo ra hiệu ứng. Bạn cần 2 bản của cùng một clip: bản gốc làm nền, bản thứ hai chỉ còn người (đã xóa nền). Có 2 cách làm:
- Trong CapCut: kéo clip vào 2 track chồng nhau, chọn track trên, bấm Xóa nền (Remove background) để còn mỗi người.
- Nhờ Claude chạy code: hợp khi có nhiều clip, Claude tách nền từng khung hình và xuất ra video mask đen trắng.
Cấu trúc Prompt (cho Claude):
Mình gửi [số] clip dọc 1080×1920. Tách người khỏi nền cho từng clip bằng rembg, model u2net_human_seg, chạy từng khung hình.
Làm mượt mask giữa 2 khung liền nhau (60% khung hiện tại, 40% khung trước) để viền không nháy.
Xuất mỗi clip 1 file mask đen trắng cùng độ dài, kèm 1 file JSON ghi vị trí đỉnh đầu và mép trái phải của đầu theo từng khung, để bước sau đặt chữ bám theo đầu.
Mẹo: xem thử 1 khung đã tách nền, đặt lên nền đỏ. Viền tóc sạch thì làm tiếp, còn lem nền thì render lại clip với phông trơn hơn.
Bước 4: Nhờ Claude viết chữ động rồi kẹp vào giữa

Claude viết animation chữ bằng HTML, chia làm 2 lớp: lớp sau (chữ sẽ bị người che, như số “0” đỏ sau đầu) và lớp trước (chữ đè lên người, như phụ đề). Khi ghép, thứ tự là: nền, chữ lớp sau, người đã tách nền, chữ lớp trước.
Cấu trúc Prompt:
Dựng chữ động cho video dọc 1080×1920, 24fps, dài [số] giây, gồm các cảnh: [cảnh 1: 0 đến 3,9 giây, clip c1; cảnh 2: …].
Viết 1 file HTML có hàm render(t, layer) vẽ đúng khung tại giây t, layer là “back” hoặc “front”. Không dùng CSS animation hay timer.
Kiểu chữ: Montserrat 900 màu trắng, chữ bật lên co giãn rồi mờ dần khi biến mất; từ khóa dùng Anton màu đỏ #C8102E, hiện từng ký tự.
Lớp back: [chữ to sau đầu, ví dụ số “0” cao 700px đặt sát mép phải đầu]. Lớp front: [phụ đề theo lời đọc].
Dùng file JSON vị trí đầu để chữ bám theo đầu.
Mọi chữ nằm trong vùng an toàn TikTok: tránh 200px trên cùng, 480px dưới cùng, và từ x 900 trở sang phải ở nửa dưới.
Chụp từng khung bằng Playwright nền trong suốt, rồi ghép bằng ffmpeg theo thứ tự: nền, chữ back, người đã tách nền, chữ front. Gửi mình 6 khung xem trước rồi mới render cả video.
Voice mình dùng ElevenLabs, giọng tiếng Việt Ngân Nguyễn. Bản đọc ra dài 34 giây vì ngắt nghỉ nhiều, nên mình nhờ Claude cắt mọi khoảng lặng còn 0,09 giây và tăng tốc 1,2 lần (giữ nguyên cao độ), còn đúng 20 giây. Sau đó Claude đo vị trí từng câu trong file voice để canh lúc chữ bật lên khớp lời.
Mẹo: luôn bắt Claude gửi khung xem trước có vẽ khung vùng an toàn. Bản đầu của mình mất khá nhiều chữ vì bị caption và cột nút bên phải của TikTok che, phải dời toàn bộ chữ vào giữa và lệch trái.
Kết luận
Cả quy trình gói lại thành một câu: ảnh có khoảng trống, video khóa máy, người tách khỏi nền, chữ kẹp ở giữa. Phần tốn công nhất không phải công cụ mà là canh thời điểm chữ khớp lời đọc và giữ chữ trong vùng an toàn, và đó đúng là phần Claude làm nhanh nhất khi prompt ghi rõ số giây và tọa độ.
Bắt đầu từ 1 cảnh thôi: 1 ảnh, 1 clip 5 giây, 1 chữ to sau đầu. Làm được cảnh đó rồi thì 4 cảnh còn lại chỉ là lặp lại.
Follow mình để biết thêm nhiều hơn về Marketing & AI tips nhé:
- Tiktok: @vutu.digital
- Facebook: vutudigital
- Instagram: @vutudigital
- Website: vutudigital.com